Lab #14 · firmansyarifuddin.id
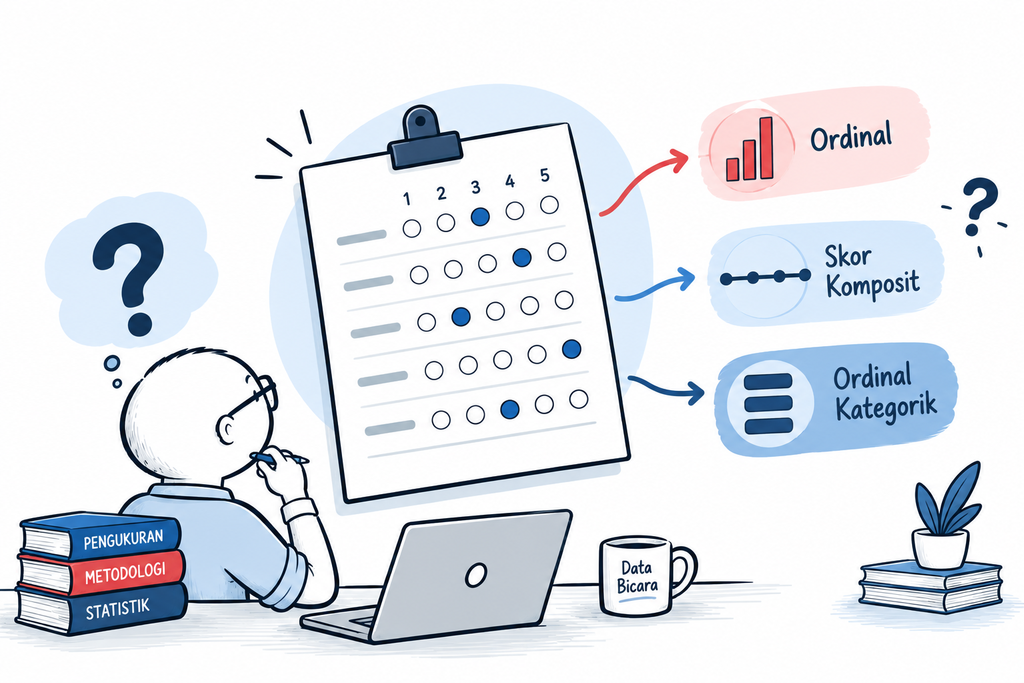
Seorang mahasiswa menulis pada definisi operasional:
“Kepuasan pasien diukur menggunakan 15 pertanyaan skala Likert. Skala ukur: ordinal.”
Di bagian analisis, ia menghitung skor total dan menyajikan nilai rata-rata. Setelah itu, skor tersebut dipotong menjadi kategori “puas” dan “tidak puas”, lalu dianalisis menggunakan Chi-Square. Instrumennya satu, tetapi datanya seperti memiliki tiga identitas.
Ketika ditanya skala ukurnya, mahasiswa mulai ragu:
“Sebenarnya ini ordinal, numerik, atau kategorik, Pak?”
Jawabannya tidak cukup hanya melihat bahwa kuesionernya menggunakan pilihan 1 sampai 5.
Kita perlu melihat data mana yang sedang dianalisis:
- jawaban pada satu pertanyaan;
- skor gabungan beberapa pertanyaan;
- atau skor gabungan yang telah dipotong kembali menjadi kategori.
Semuanya berasal dari kuesioner yang sama. Namun, bentuk data akhirnya berbeda. Akibatnya, cara penyajian dan pilihan analisisnya juga dapat berbeda.
Angka 1–5 Belum Tentu Data Numerik
Bayangkan satu pertanyaan berikut:
“Petugas memberikan informasi dengan jelas.”
Pilihan jawabannya:
- sangat tidak setuju;
- tidak setuju;
- setuju;
- sangat setuju.
Angka 1 sampai 4 berfungsi sebagai kode untuk menunjukkan urutan jawaban. Kita mengetahui bahwa “setuju” berada di atas “tidak setuju”. Namun, kita tidak dapat memastikan bahwa jarak psikologis antara “sangat tidak setuju” dan “tidak setuju” sama persis dengan jarak antara “setuju” dan “sangat setuju”.
Karena itu, jawaban satu item Likert secara klasik diperlakukan sebagai data ordinal kategorik.
Ada urutan, tetapi jarak antarkategori belum tentu sama. Angka pada data ini seperti nomor urut podium. Juara 1 memang berada di atas juara 2, tetapi bukan berarti kemampuan juara 1 tepat dua kali kemampuan juara 2. Jadi, keberadaan angka tidak otomatis membuat sebuah variabel menjadi numerik.
Bentuk Pertama: Item Likert sebagai Ordinal Kategorik
Jika setiap pertanyaan dianalisis secara terpisah, unit analisisnya adalah item Likert.
Misalnya, peneliti ingin melihat tanggapan responden terhadap pernyataan:
“Waktu tunggu pelayanan sudah sesuai harapan.”
Hasilnya dapat disajikan sebagai berikut:
| Jawaban | Jumlah | Persentase |
| Sangat tidak setuju | 8 | 8% |
| Tidak setuju | 22 | 22% |
| Setuju | 51 | 51% |
| Sangat setuju | 19 | 19% |
Penyajian seperti ini mempertahankan bentuk asli jawaban. Pembaca dapat melihat ke mana respons terkonsentrasi dan apakah terdapat jawaban yang terbelah pada dua kutub. Untuk satu item, penyajian yang paling mudah dipahami biasanya berupa:
- frekuensi;
- persentase;
- modus;
- atau median dan rentang antarkuartil jika diperlukan.
Boone dan Boone membedakan dengan tegas antara Likert-type item dan Likert scale. Satu item adalah satu pertanyaan dengan kategori jawaban berurutan. Sementara itu, skala Likert merupakan gabungan beberapa item yang dirancang untuk mengukur konstruk yang sama. Perbedaan ini terlihat sederhana, tetapi menentukan seluruh jalur analisis berikutnya.
Bentuk Kedua: Skor Komposit atau Summed Likert Scale
Sekarang bayangkan kepuasan pasien tidak diukur dengan satu pertanyaan, melainkan 15 pertanyaan yang mencakup:
- kejelasan informasi;
- keramahan petugas;
- waktu tunggu;
- kenyamanan ruang pelayanan;
- kemudahan prosedur;
- dan pengalaman pelayanan lainnya.
Skor kelima belas pertanyaan kemudian dijumlahkan.
Jika setiap item menggunakan skor 1–4, maka:
- skor minimum = 15 × 1 = 15;
- skor maksimum = 15 × 4 = 60.
Setiap responden akhirnya memiliki satu skor kepuasan antara 15 dan 60. Data ini tidak lagi merepresentasikan jawaban terhadap satu pertanyaan. Ia menjadi skor komposit, yaitu ringkasan dari beberapa item yang dimaksudkan untuk mengukur satu konstruk. Skor komposit dapat dihitung melalui:
- penjumlahan skor seluruh item;
- rata-rata skor seluruh item;
- skor berdasarkan dimensi;
- atau sistem pembobotan tertentu jika instrumennya memang mengatur demikian.
Namun, penjumlahan tidak boleh dilakukan hanya karena seluruh pertanyaannya memakai pilihan 1–4. Item-item tersebut terlebih dahulu harus masuk akal secara konseptual sebagai satu konstruk. Arah skornya harus sama, item negatif harus melalui reverse scoring, dan kualitas instrumennya perlu didukung oleh bukti validitas serta reliabilitas yang memadai.
Lima belas pertanyaan yang kebetulan menggunakan pilihan jawaban sama belum tentu boleh dijumlahkan. Menyatukan item yang tidak mengukur konsep sama ibarat menjumlahkan suhu tubuh, tinggi badan, dan tekanan darah, lalu menamainya “skor kesehatan”. Secara matematika bisa dikerjakan. Secara ilmiah belum tentu memiliki arti.
Apakah Skor Komposit Berubah Menjadi Interval?
Di sinilah perdebatan metodologis dimulai.
Secara asal, skor komposit dibangun dari beberapa item ordinal. Namun, ketika sejumlah item yang saling berkaitan digabungkan, skor tersebut memiliki lebih banyak kemungkinan nilai dan sering menunjukkan perilaku yang lebih mendekati data kontinu. Misalnya, satu item hanya memiliki empat kemungkinan jawaban: 1, 2, 3, dan 4. Akan tetapi, skor gabungan 15 item memiliki rentang 15–60 dengan jauh lebih banyak kemungkinan nilai.
Dalam praktik penelitian, skor komposit seperti ini sering dianalisis menggunakan:
- mean dan standar deviasi;
- uji-t;
- ANOVA;
- korelasi Pearson;
- atau regresi linear.
Norman menunjukkan bahwa sejumlah metode parametrik cukup tahan terhadap pelanggaran asumsi tertentu pada data Likert. Sullivan dan Artino juga menjelaskan bahwa analisis parametrik dapat digunakan dalam kondisi yang memadai, khususnya ketika beberapa item digabungkan menjadi skala dan distribusi datanya mendukung. Namun, skor komposit tidak otomatis berubah menjadi data interval hanya karena tombol Transform → Compute Variable telah ditekan.
Peneliti tetap perlu memeriksa:
- apakah item mengukur konstruk yang sama;
- apakah skala telah tervalidasi;
- apakah arah skornya konsisten;
- berapa banyak kemungkinan skor yang dihasilkan;
- bagaimana distribusi datanya;
- apakah terdapat efek lantai atau efek plafon;
- dan apakah asumsi metode statistik yang dipilih terpenuhi.
Di sisi lain, Liddell dan Kruschke mengingatkan bahwa memperlakukan data ordinal sebagai data metrik dapat menghasilkan estimasi efek yang terdistorsi dalam kondisi tertentu. Artinya, penggunaan analisis parametrik bukan larangan mutlak, tetapi juga bukan izin otomatis. Posisi yang paling aman bukan berkata:
“Semua data Likert adalah ordinal sehingga tidak boleh dihitung rata-ratanya.”
Bukan pula:
“Kalau itemnya banyak, pasti berubah menjadi interval.”
Yang lebih tepat adalah:
Skor komposit dapat diperlakukan sebagai data numerik yang mendekati kontinu apabila konstruksi instrumen, karakteristik skor, tujuan analisis, dan asumsi statistiknya mendukung.
Bentuk Ketiga: Skor Komposit yang Dikategorikan Kembali
Setelah memperoleh skor 15–60, mahasiswa sering memotongnya menjadi:
- kepuasan rendah;
- kepuasan sedang;
- kepuasan tinggi.
Pada tahap ini, data yang semula berupa skor komposit kembali menjadi ordinal kategorik. Urutannya masih jelas: tinggi berada di atas sedang, dan sedang berada di atas rendah. Namun, nilai asli setiap responden sudah disembunyikan di balik kategori.
Misalnya:
| Responden | Skor asli | Kategori |
| A | 30 | Sedang |
| B | 44 | Sedang |
| C | 45 | Tinggi |
Responden A dan B ditempatkan dalam kategori yang sama meskipun skornya berbeda 14 poin. Sebaliknya, responden B dan C dipisahkan ke dalam dua kategori meskipun skornya hanya berbeda satu poin. Inilah harga yang dibayar ketika skor numerik diubah menjadi kategori: analisis menjadi lebih sederhana, tetapi informasi menjadi lebih kasar.
Altman dan Royston mengingatkan bahwa mengategorikan data kontinu—terutama menjadi dua kelompok—dapat membuang informasi, mengurangi kekuatan statistik, dan membuat hasil sangat bergantung pada titik potong yang dipilih.
Karena itu, jika skor komposit masih dapat dianalisis dalam bentuk aslinya, peneliti tidak selalu perlu buru-buru mengubahnya menjadi “rendah” dan “tinggi”. Kategori boleh dibuat untuk kebutuhan deskriptif atau keputusan program. Namun, dasar titik potongnya harus jelas: berasal dari instrumen baku, pedoman program, pertimbangan klinis, teori, atau metode kategorisasi yang telah ditetapkan sebelumnya.
Jangan membuat kategori hanya karena tabel skripsi terasa belum lengkap tanpa kata “baik” dan “kurang”.
Bagaimana Jika Hanya Dibuat Dua Kategori?
Misalnya skor kepuasan diubah menjadi:
- tidak puas;
- puas.
Secara substantif, kedua kategori tersebut tetap memiliki urutan. Namun, dalam analisis statistik, variabel ini biasanya diperlakukan sebagai kategorik biner. Data tersebut dapat disajikan dengan frekuensi dan persentase. Jika menjadi variabel luaran, analisis lanjutannya dapat menggunakan regresi logistik biner. Jika hanya ingin melihat hubungan dua variabel kategorik, Chi-Square mungkin dapat digunakan, selama persyaratannya terpenuhi. Tetapi sekali lagi, uji statistik tidak dipilih hanya dari skala ukur satu variabel.
Pemilihan uji juga bergantung pada:
- peran variabel sebagai bebas atau terikat;
- jumlah kelompok;
- pasangan atau independensi pengamatan;
- distribusi data;
- tujuan analisis;
- dan struktur desain penelitian.
Mengetahui skala ukur adalah pintu masuk. Bukan seluruh rumah.
Persentase Indeks Tidak Otomatis Menjadi Rasio
Kesalahan lain muncul ketika skor komposit dikonversi menjadi indeks 0–100. Karena tampilannya berupa persentase, mahasiswa kadang menulis skala ukurnya sebagai rasio. Padahal, perubahan tampilan angka tidak otomatis mengubah sifat pengukurannya. Misalnya, skor 45 dari skor maksimum 60 diubah menjadi:
Indeks = 45 ÷ 60 × 100 = 75%
Angka 75 persen tersebut menunjukkan posisi skor terhadap skor maksimum yang ditetapkan. Ia bukan berarti responden memiliki “75 persen kepuasan” dalam arti fisik yang benar-benar terukur.
Demikian pula, skor nol belum tentu menunjukkan ketiadaan mutlak konstruk psikologis yang diukur. Oleh karena itu, indeks 0–100 hasil transformasi skor Likert tidak otomatis dapat disebut sebagai skala rasio. Mengalikan skor dengan 100 hanya mengganti pakaian angkanya. Ia tidak serta-merta mengganti tubuh pengukurannya.
Satu Instrumen, Tiga Bentuk Data
Agar lebih jelas, perhatikan satu contoh berikut. Variabel kepuasan diukur dengan 10 item berskala 1–5.
Jika satu item dianalisis
Data: jawaban 1–5 pada setiap pertanyaan.
Bentuk: ordinal kategorik.
Penyajian: frekuensi dan persentase setiap jawaban.
Analisis: metode untuk data ordinal atau kategorik sesuai tujuan penelitian.
Jika seluruh item dijumlahkan
Data: skor total 10–50.
Bentuk: skor komposit.
Penyajian: mean dan standar deviasi atau median dan rentang antarkuartil.
Analisis: parametrik atau nonparametrik berdasarkan sifat skor, desain, dan asumsi.
Jika skor total dibagi menjadi rendah–sedang–tinggi
Data: tiga kategori berurutan.
Bentuk: ordinal kategorik.
Penyajian: frekuensi dan persentase setiap kategori.
Analisis: Chi-Square, uji tren, regresi ordinal, atau metode lain sesuai pertanyaan penelitian.
Instrumennya tidak berubah. Yang berubah adalah unit data yang dibawa ke meja analisis.
Peta Sederhana Memilih Penyajian dan Analisis
| Data yang dianalisis | Bentuk data akhir | Penyajian utama | Contoh analisis |
| Satu item Likert | Ordinal kategorik | Frekuensi, persentase, modus, median | Chi-Square, Mann–Whitney, Kruskal–Wallis, Spearman, regresi ordinal |
| Skor total/rata-rata beberapa item | Skor komposit | Mean–SD atau median–IQR, minimum–maksimum | Uji-t, ANOVA, Pearson, regresi linear atau alternatif nonparametrik |
| Skor menjadi rendah–sedang–tinggi | Ordinal kategorik | Frekuensi dan persentase | Chi-Square, uji tren, regresi ordinal |
| Skor menjadi ya–tidak/puas–tidak puas | Kategorik biner | Frekuensi dan persentase | Chi-Square, regresi logistik biner |
| Indeks skor 0–100 | Skor hasil transformasi | Mean–SD atau median–IQR | Mengikuti sifat skor asal dan asumsi analisis |
Tabel tersebut bukan mesin otomatis pemilih uji. Ia hanya menunjukkan jalur yang masuk akal.
Uji statistik tetap harus mengikuti pertanyaan penelitian dan desain data.
Definisi Operasional Harus Mengikuti Data Akhir
Kekacauan sering dimulai dari definisi operasional.
Mahasiswa menulis skala ukur “ordinal”, tetapi pada analisis menggunakan skor total sebagai data numerik. Ada pula yang menulis “rasio” hanya karena skor telah dikonversi menjadi persen. Sebagian lainnya menulis “Likert” pada kolom skala ukur, padahal Likert adalah metode pemberian respons, bukan salah satu dari empat skala ukur klasik.
Definisi operasional sebaiknya menjelaskan secara berurutan:
- konstruk yang diukur;
- instrumen dan jumlah item;
- pilihan respons;
- aturan pemberian skor;
- cara membentuk skor komposit;
- bentuk data akhir;
- dasar kategorisasi jika digunakan;
- skala ukur pada tahap analisis;
- cara penyajian;
- metode analisis yang direncanakan.
Contohnya:
“Kepuasan pasien diukur menggunakan 15 item dengan pilihan respons 1–4. Setelah reverse scoring pada item negatif, seluruh skor dijumlahkan menjadi skor komposit 15–60. Skor dianalisis sebagai data numerik dan disajikan menggunakan mean–SD apabila distribusinya memadai atau median–IQR apabila distribusinya menceng.”
Jika skor akan dikategorikan:
“Skor komposit kemudian dikelompokkan menjadi kepuasan rendah, sedang, dan tinggi berdasarkan titik potong yang telah ditetapkan. Bentuk data akhir untuk analisis kategorik adalah ordinal.” Dengan penjelasan tersebut, instrumen, skoring, skala ukur, penyajian, dan analisis berada pada satu jalur yang konsisten.
Pertanyaan yang Harus Dijawab Sebelum Memilih Uji
Sebelum membuka menu analisis di SPSS, tanyakan:
- Apakah saya menganalisis satu item atau gabungan beberapa item?
- Jika digabungkan, apakah item tersebut benar-benar mengukur konstruk yang sama?
- Apakah skor akan dipertahankan atau dikategorikan?
- Jika dikategorikan, dari mana titik potongnya berasal?
- Apa bentuk data akhir yang masuk ke analisis?
- Apakah data akan disajikan sebagai angka atau kategori?
- Apa pertanyaan penelitian yang ingin dijawab?
- Apakah asumsi uji yang dipilih terpenuhi?
Jika pertanyaan-pertanyaan ini belum selesai, memilih uji statistik hanya akan menjadi kegiatan menebak-nebak menu.
Penutup
Data Likert tidak memiliki satu identitas sepanjang perjalanan penelitian. Ia dapat berangkat sebagai jawaban ordinal pada satu item, digabungkan menjadi skor komposit, lalu dipotong kembali menjadi kategori. Setiap perubahan membawa konsekuensi terhadap informasi yang dipertahankan, cara penyajian, dan metode analisis. Karena itu, jangan hanya bertanya:
“Kuesioner saya memakai skala Likert, jadi harus menggunakan uji apa?”
Pertanyaan yang lebih tepat adalah:
“Bagian mana dari data Likert yang sedang saya analisis, dan dalam bentuk apa data itu sampai di meja statistik?”
Statistik tidak membaca lembar kuesioner kita. Statistik membaca data terakhir yang kita serahkan kepadanya.
Sumber Bacaan
- Altman, D. G., & Royston, P. (2006). The cost of dichotomising continuous variables. BMJ, 332(7549), 1080.
- Boone, H. N., & Boone, D. A. (2012). Analyzing Likert data. Journal of Extension, 50(2).
- Bürkner, P. C., & Vuorre, M. (2019). Ordinal regression models in psychology: A tutorial. Advances in Methods and Practices in Psychological Science, 2(1), 77–101.
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong?. Journal of Experimental Social Psychology, 79, 328–348.
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632.
- Sullivan, G. M., & Artino, A. R. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542.